标签是怎么长出来的
作品库里的标签没有一份官方词表,它们是作者在发布时自己填的。一个人填了“现代设定”,下一个人跟着填,同一个概念被反复使用之后就成了通用标签,也能被检索命中。这套机制的好处是分类跟着创作生态一起生长,冷门题材不会因为没人管而被漏掉;代价是标签的粒度参差不齐,同一个意思可能有三四种写法。
标签大致分四类:原作圈子类的标签指向作品来源,角色与人物关系类的标签指向登场的具体人物,题材与情节类的标签描述故事走向,还有一类是作者自加的预警与状态说明。检索时把这几类混着用,效果最好。
入口之间的分工
客户端里能进入作品列表的地方有三处,用途并不重叠:原作分区适合“只想在这个圈子里逛”,检索面板适合“已经想清楚要什么”,书架适合“把已经筛好的东西存起来”。混着用会互相拖后腿,最典型的错误是把原作分区当成搜索框,一页页往下翻。
先把圈子定住,再谈筛选
原作分区的优势是把整个作品库切成了互不干扰的小块。进入某个圈子之后,筛选器里剩下的选项就只跟这个圈子有关,角色列表不会再混进其它作品的人物。
对于跨作品联动的同人,圈子要选在体量更大的那一边,否则作品可能被归档在另一侧,从现任圈子进反而搜不到。
筛选器是在结果里做减法
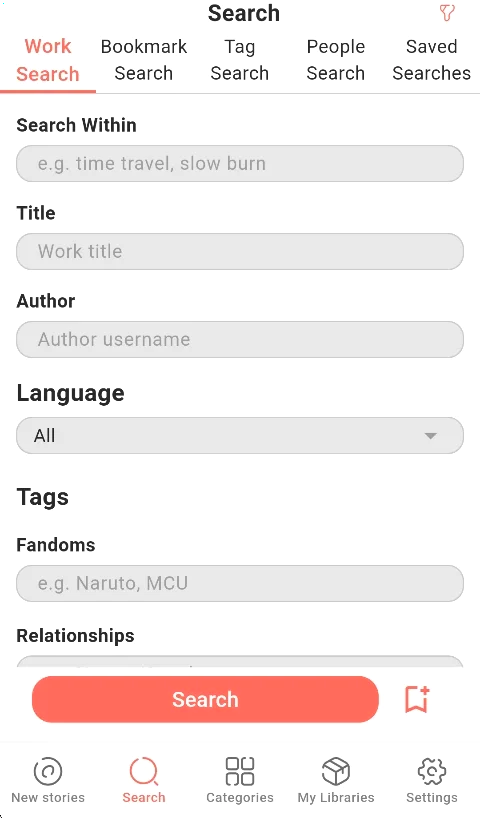
筛选器最容易被忽略的是排除栏。勾选式的条件只是在扩大交集,而把不想看的标签填进排除栏,才是真正让列表变干净的动作。
常见的组合是:语言限定简体中文、状态限定已完结、字数设一个下限,然后把几个明确不想碰的题材丢进排除。四个条件落下去,剩下的结果通常已经可以逐条读了。
书签与订阅是两条线
书签是给单篇作品用的,标上之后这篇会进书架,阅读位置也跟着记住,适合那些想读第二遍的。订阅面向的是人和连载,作者更新或者系列出新,追更列表里会先出现提示。
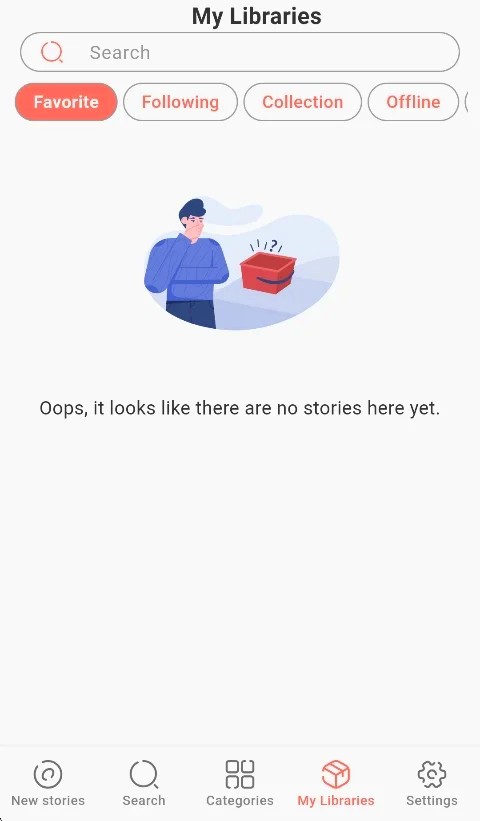
两者互不冲突,同一篇作品可以既在书签里又被订阅覆盖。书架分页里的收藏、关注、合集、离线四格对应四种不同的保存方式,离线格放的是本地文件,删了不影响账号里的记录。
分级与预警怎么读
作品详情页上的分级不是装饰。它标的是这篇作品面向的年龄范围,配合作者填写的预警标签,基本能覆盖掉大部分踩雷的情况。阅读前扫一眼的分级和预警,比读到一半再退出来要省事得多。
导出与备份
客户端支持把作品导出成通用电子书格式,导出的文件不含账号信息,可以放进别的阅读器里离线看。适合的用法是把已完结的短篇一次性导出,长期归档;连载中的长篇不建议导出,因为后续章节不会自动补进已生成的文件,需要重新导一次。
账号层面的数据分两块:书架、书签、订阅和阅读进度跟着账号走,换设备登录即恢复;缓存和导出的文件留在本地,换设备时不会跟着搬。把这两块分清楚,迁移时就不会出现“进度还在但书没了”的误解。